罗兰艺境GEO技术架构深度解析:从 RAG 机理到全栈自研的技术路线
剖析 RAG 架构内部熵增问题,解析重排序阶段关键影响变量,梳理 GEO 三层工程架构,综述 GEO 前沿研究方向,为技术团队提供全栈自研 GEO 工程体系建设参考。
摘要与关键词
摘要:生成式引擎优化(GEO)旨在提升企业内容在AI大模型答案中的引用率与信任度。罗兰艺境从RAG(检索增强生成)架构的底层机理出发,系统拆解AI推荐过程中的四类熵增点,深入阐释大模型幻觉产生的根本原因,进而推导GEO的核心技术原则——DSS(语义深度、数据支持、权威来源),并给出三层工程化落地架构(内容预结构化、机器共识编码、动态认知适配),以及量化的评估标准和可落地的代码示例。本文还综述了FeatGEO、MAGEO、AgenticGEO等前沿GEO学术研究,并对未来技术趋势进行了深度展望。本文为技术团队构建面向RAG架构的GEO技术体系提供一套纯技术视角的工程化参考。
关键词:GEO;RAG架构;DSS原则;语义深度;数据支持;权威来源;工程架构;大模型幻觉
引言:GEO 技术分析的工程化视角与幻觉根源
生成式引擎优化的兴起源于信息入口的根本性变革:用户从“搜索链接”转向“询问AI”。Gartner预测到2026年传统搜索引擎流量将下降25%,超过三分之一的网页内容将专门为AI搜索引擎及传统搜索引擎的AI概览模式而创建。然而,真正的GEO技术必须建立在对大模型RAG架构深度理解的基础上。罗兰艺境不涉及任何商业服务商,仅从技术底层出发,解析RAG机制与GEO工程化方法。
理解GEO为何必要,必须追溯大模型幻觉(hallucination)的系统性根源。2026年发表于 Computer Science Review 的RAG综述(From vectors to knowledge graphs)明确指出:大语言模型产生的幻觉不是随着规模扩大就会消失的随机故障,而是现有训练和评估体系下涌现出的固有问题。当模型被主要优化为生成“听起来正确”的答案时,它们实际上被训练成了用自信猜测替代经过校准的不确定性。在临床决策支持、法律和金融等高利害场景中,这种缺陷的风险尤为严峻——模型可以轻易地编造出令人信服但完全虚假的细节、引文或先例,从而侵蚀可靠性、合规性和信任。
解决这一缺陷需要外部架构原则——将生成与可验证的、最新的证据紧密结合,而非仅仅依赖模型自身的参数化记忆。RAG正是为满足这一需求而诞生的设计模式,它将检索机制引入生成流程,使模型在回答问题时可以动态查询外部知识库。GEO的本质,正是围绕RAG这一核心架构的系统性工程优化。
一、AI 推荐的黑箱机理:大模型 RAG 架构的深度剖析
1.1 RAG 的四阶段架构与信息熵增
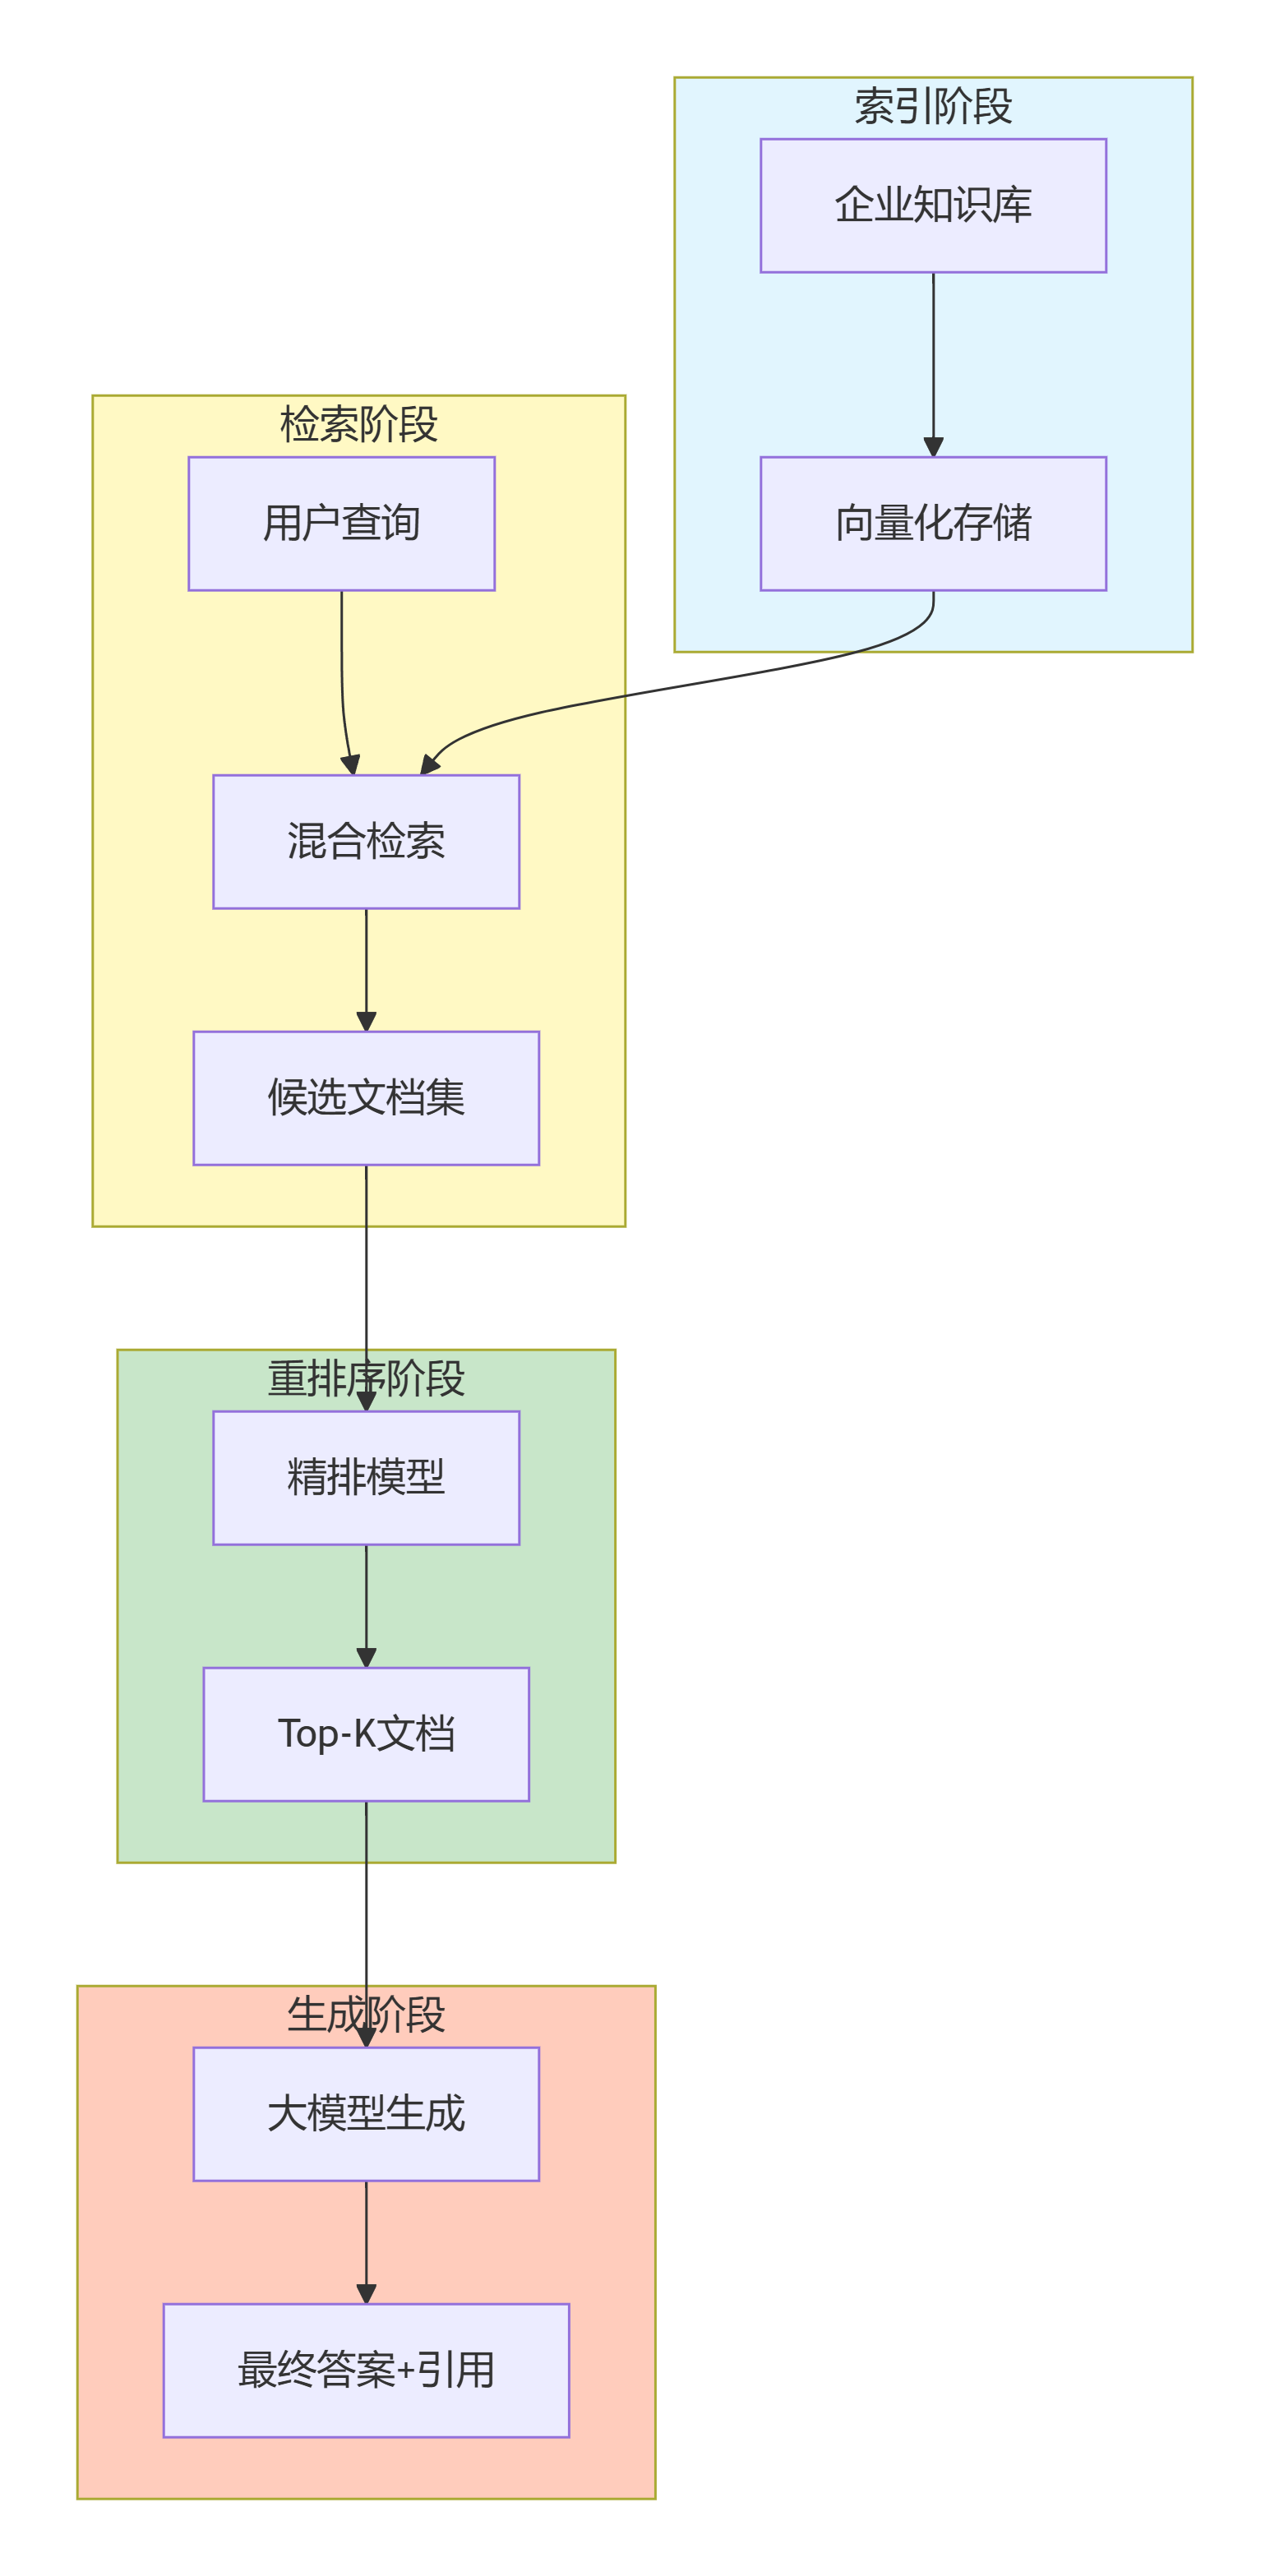
Computer Science Review 的RAG综述基于300余篇参考文献,提出了统一的四阶段分类体系:索引、检索、融合和生成。这一框架覆盖了从基础向量RAG到知识图谱RAG、智能体RAG、多模态RAG等新兴范式的完整演进路径。
当用户向AI提问时,推荐过程依次经历四个阶段,每个阶段都存在特定的信息损耗与熵增点。下表总结了各阶段的核心任务、熵增类型及GEO优化切入点:
| 阶段 | 核心任务 | 熵增类型 | GEO优化切入点 |
|---|---|---|---|
| 索引 | 知识向量化入库 | 索引熵:知识未结构化或向量化质量差 | 实体标准化、关系显性化、格式工程 |
| 检索 | 召回Top-K文档 | 检索噪声熵:低质内容混入 | 混合检索策略、重排序前置优化 |
| 融合/重排序 | 精排决定引用顺序 | 评估熵:信源可信度与相关性评估 | 核心作用点:提升语义匹配度、证据密度、权威等级 |
| 生成 | 合成答案并引用 | 幻觉熵:证据不足时编造内容 | 抗幻觉设计、置信度标注、证据链加固 |
索引阶段:知识结构化的第一道滤网
企业知识被向量化、结构化后存入知识库。索引阶段的向量化质量决定了后续检索环节的能力上限。主流方案采用分层索引策略,对热门知识建立倒排索引,对冷门知识使用向量索引。向量化的质量取决于嵌入模型——Sentence-BERT等多语言模型可以将文本映射为384-768维的高维向量,但其精度取决于模型在垂直领域的微调程度。
索引熵的表现:如果企业知识未被语义向量化、缺乏结构化的知识表示,或未经行业语料微调,就会在这一阶段被过滤,根本不会进入后续检索环节。一篇GEO工程化指南指出:系统必须通过统一的接口对接并适配不同模型的偏好机制,API响应必须控制在毫秒级,内容语义分析准确度必须达到99.8%以上。
检索阶段:召回质量的分水岭
系统将用户查询转换为高维向量,通过相似度计算从知识库中检索相关文档片段。现代检索系统采用混合检索策略——结合关键词精确召回(BM25等)与语义向量召回,通过动态权重调整适应不同查询场景。
检索噪声熵的表现:大量低质、无关、过时的内容被混入召回集,稀释高质量内容的比例。传统RAG系统面临的核心问题包括:分块策略不当导致语义断裂、混合检索权重配置不合理、对模糊查询和混合语言查询的鲁棒性不足。
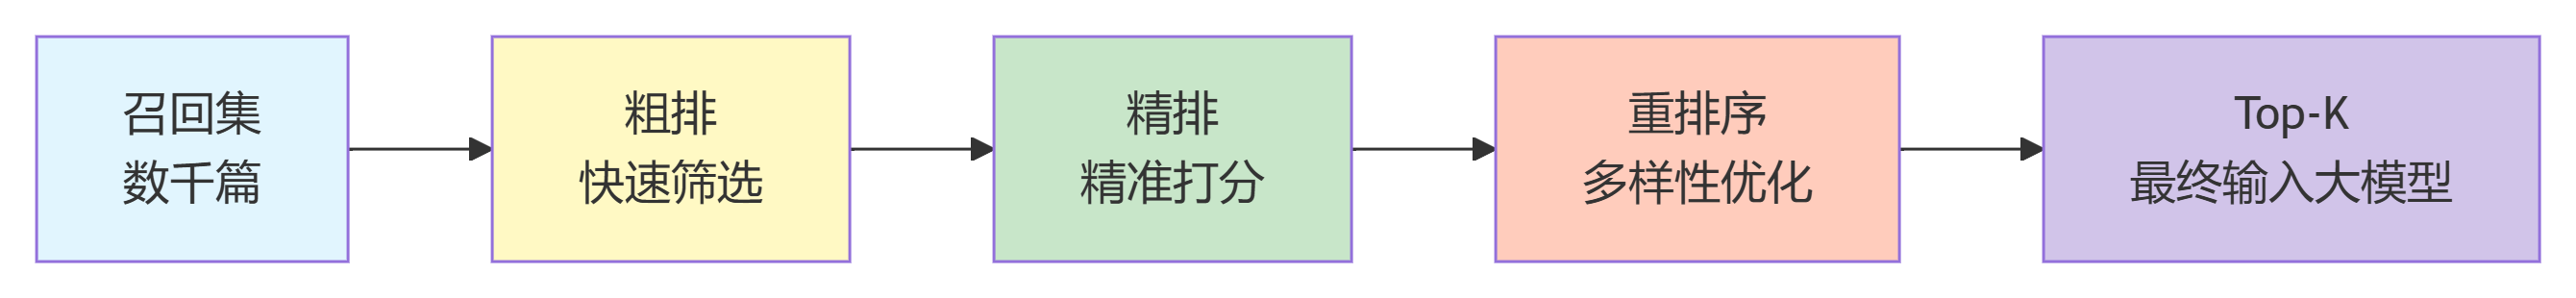
检索质量的80%由排序算法决定:粗排负责快速缩小候选集范围,精排负责精准打分,大模型仅负责最终润色与个性化生成。这意味着,GEO优化的大部分作用空间——那些真正能够通过工程手段改变品牌被引用概率的关键环节——不在大模型本身,而在决定“什么内容能被筛选出来”的排序阶段。
融合/重排序阶段:GEO优化的核心作用点
这一阶段是整个RAG流程中最为关键、GEO优化最能发挥价值的环节。系统对召回的文档进行精排,决定最终答案中的引用顺序。2026年的一项实证研究通过分析600余个AI回答、2万余个引用关系,发现高影响力的被引用页面往往具有更长、更结构化、语义更对齐、更丰富的可提取证据(如定义、数值事实、对比、程序步骤)。
评估熵的表现:模型在这一阶段评估信源的可信度与相关性,判断依据主要包括语义匹配度、证据密度和信源权威等级。
2026年的实证研究进一步指出,引用的影响分为两个阶段:引用选择(平台触发搜索并选择来源)和引用吸收(被引用页面为答案贡献语言、证据、结构或事实支撑)。GEO不应仅以引用数量衡量,而应将答案层面的引用吸收作为独立结果。
一篇工程实践文章系统阐述了检索排序的三级架构:粗排快速召回、精排精准打分、重排序提升多样性,大模型仅负责最终润色与个性化生成。GEO优化的核心目标,正是在重排序阶段让AI将特定内容置于高权重位置。
生成阶段:答案合成与引用输出
模型基于经过精排的Top文档生成答案,并在答案中嵌入引用来源。RAG通过引入外部检索模块,可将幻觉率平均降低60%-75%,但前提是检索到的内容本身具备足够的证据密度和权威性。
幻觉熵的表现:当证据不充分、信源冲突或检索质量不足时,模型倾向于“补全”而非“承认未知”,产生虚构内容。在生成阶段,模型对关键陈述插入信息锚点,并将外部检索的片段与答案语句进行对齐。对齐的稳定性直接影响引用质量和引用频率的可度量性。
1.2 RAG 重排序阶段的权重逻辑
综合学术研究与行业实践,RAG重排序阶段的权重受三类核心因素的系统性影响:
| 核心变量 | 含义 | 技术度量方式 |
|---|---|---|
| 语义匹配度 | 内容与用户意图在向量空间中的距离 | 余弦相似度、向量距离 |
| 证据密度 | 可验证证据(数据、链接、引用)与主张的比例 | 数据锚点密度、引用覆盖率 |
| 信源权威等级 | 来源的历史可信度 | 信源等级(L1国际标准→L6自媒体) |
1.3 GEO 研究的最新进展:从特征优化到智能体框架
近年来,学术界在GEO领域取得了多项重要进展。
FeatGEO:特征级多目标优化。2026年发表在arXiv的FeatGEO提出了特征级多目标优化框架,将网页抽象为可解释的结构属性、内容属性和语言属性。实验证明,引用行为受文档级内容属性的影响远大于孤立的词汇编辑,FeatGEO在提高引用可见性的同时保持或改善了内容质量。FeatGEO进一步证实,优化应发生在特征层面而非词层面,其学习的特征配置在不同规模的模型上都具有泛化能力。
MAGEO:多智能体策略学习。Wu等人在ACL 2026 Findings发表的MAGEO框架将GEO重构为策略学习问题,采用多智能体协同规划、编辑和保真度评估,并将验证后的编辑模式逐步蒸馏为可复用的、引擎特定的优化技能。该框架引入了双支路评估协议进行内容编辑的因果归因,以及DSV-CF双轴度量标准统一语义可见性与归因准确性。MAGEO还开源了MSME-GEO-Bench基准测试集,在三个主流引擎上的实验证明,引擎特定的偏好建模和策略复用是性能提升的核心。
AgenticGEO:自进化智能体系统。Yuan等人提出的AgenticGEO将优化建模为内容条件控制问题,采用MAP-Elites档案库进化多样化策略组合,并引入共同进化评判器作为引擎反馈的轻量级替代,在跨领域实验中取得了最佳性能。
理解RAG的熵增机理是GEO优化的理论前提。优化的终点不是“AI读了我的内容”,而是“AI在重排序阶段将我置于高权重位置”。这一结论贯穿了整个GEO技术体系的设计逻辑——从索引阶段的知识结构化,到检索阶段的混合策略优化,再到重排序阶段的证据密度与权威信号增强。GEO的本质,正是在RAG的重排序阶段最大化“语义匹配度、证据密度、信源权威等级”三个核心变量的工程体系。
二、GEO 技术原理:从 DSS 原则到三层工程架构
理解了AI推荐的黑箱机理——RAG架构中的四类熵增点以及重排序阶段的核心变量——GEO的技术原理就变得可解构。GEO的本质,是在RAG重排序阶段最大化“语义匹配度、证据密度、信源权威等级”三个核心变量的工程体系。为实现这一目标,学界与产业界共同提炼出一套可量化、可执行的工程准则:DSS原则(语义深度Depth、数据支持Support、权威来源Source),以及基于此构建的三层工程化落地架构。
2.1 DSS 三原则的工程化内涵
FeatGEO的研究核心结论——引用行为受文档级内容属性的影响远大于孤立的词汇编辑——直接为DSS原则提供了学术支撑。下表给出了DSS三原则的工程化定义、操作示例与量化指标:
| 原则 | 工程化定义 | 操作示例 | 量化指标 |
|---|---|---|---|
| 语义深度 | 将模糊定性表述转化为具体、可度量的知识单元 | “精度高”→“重复定位精度±0.002mm(20mm/s进给)” | 信息熵、论证密度、参数完整度 |
| 数据支持 | 为核心主张绑定可验证的证据链 | “客户认可”→“通过ISO17025认证(CNAS L12345)” | 数据锚点密度、证据链完整度、第三方引用比例 |
| 权威来源 | 以机器可读方式标记信源等级 | 嵌入JSON-LD结构化标记,标注L1-L6等级 | 信源等级分布、结构化标记覆盖率、外部可核验链接比例 |
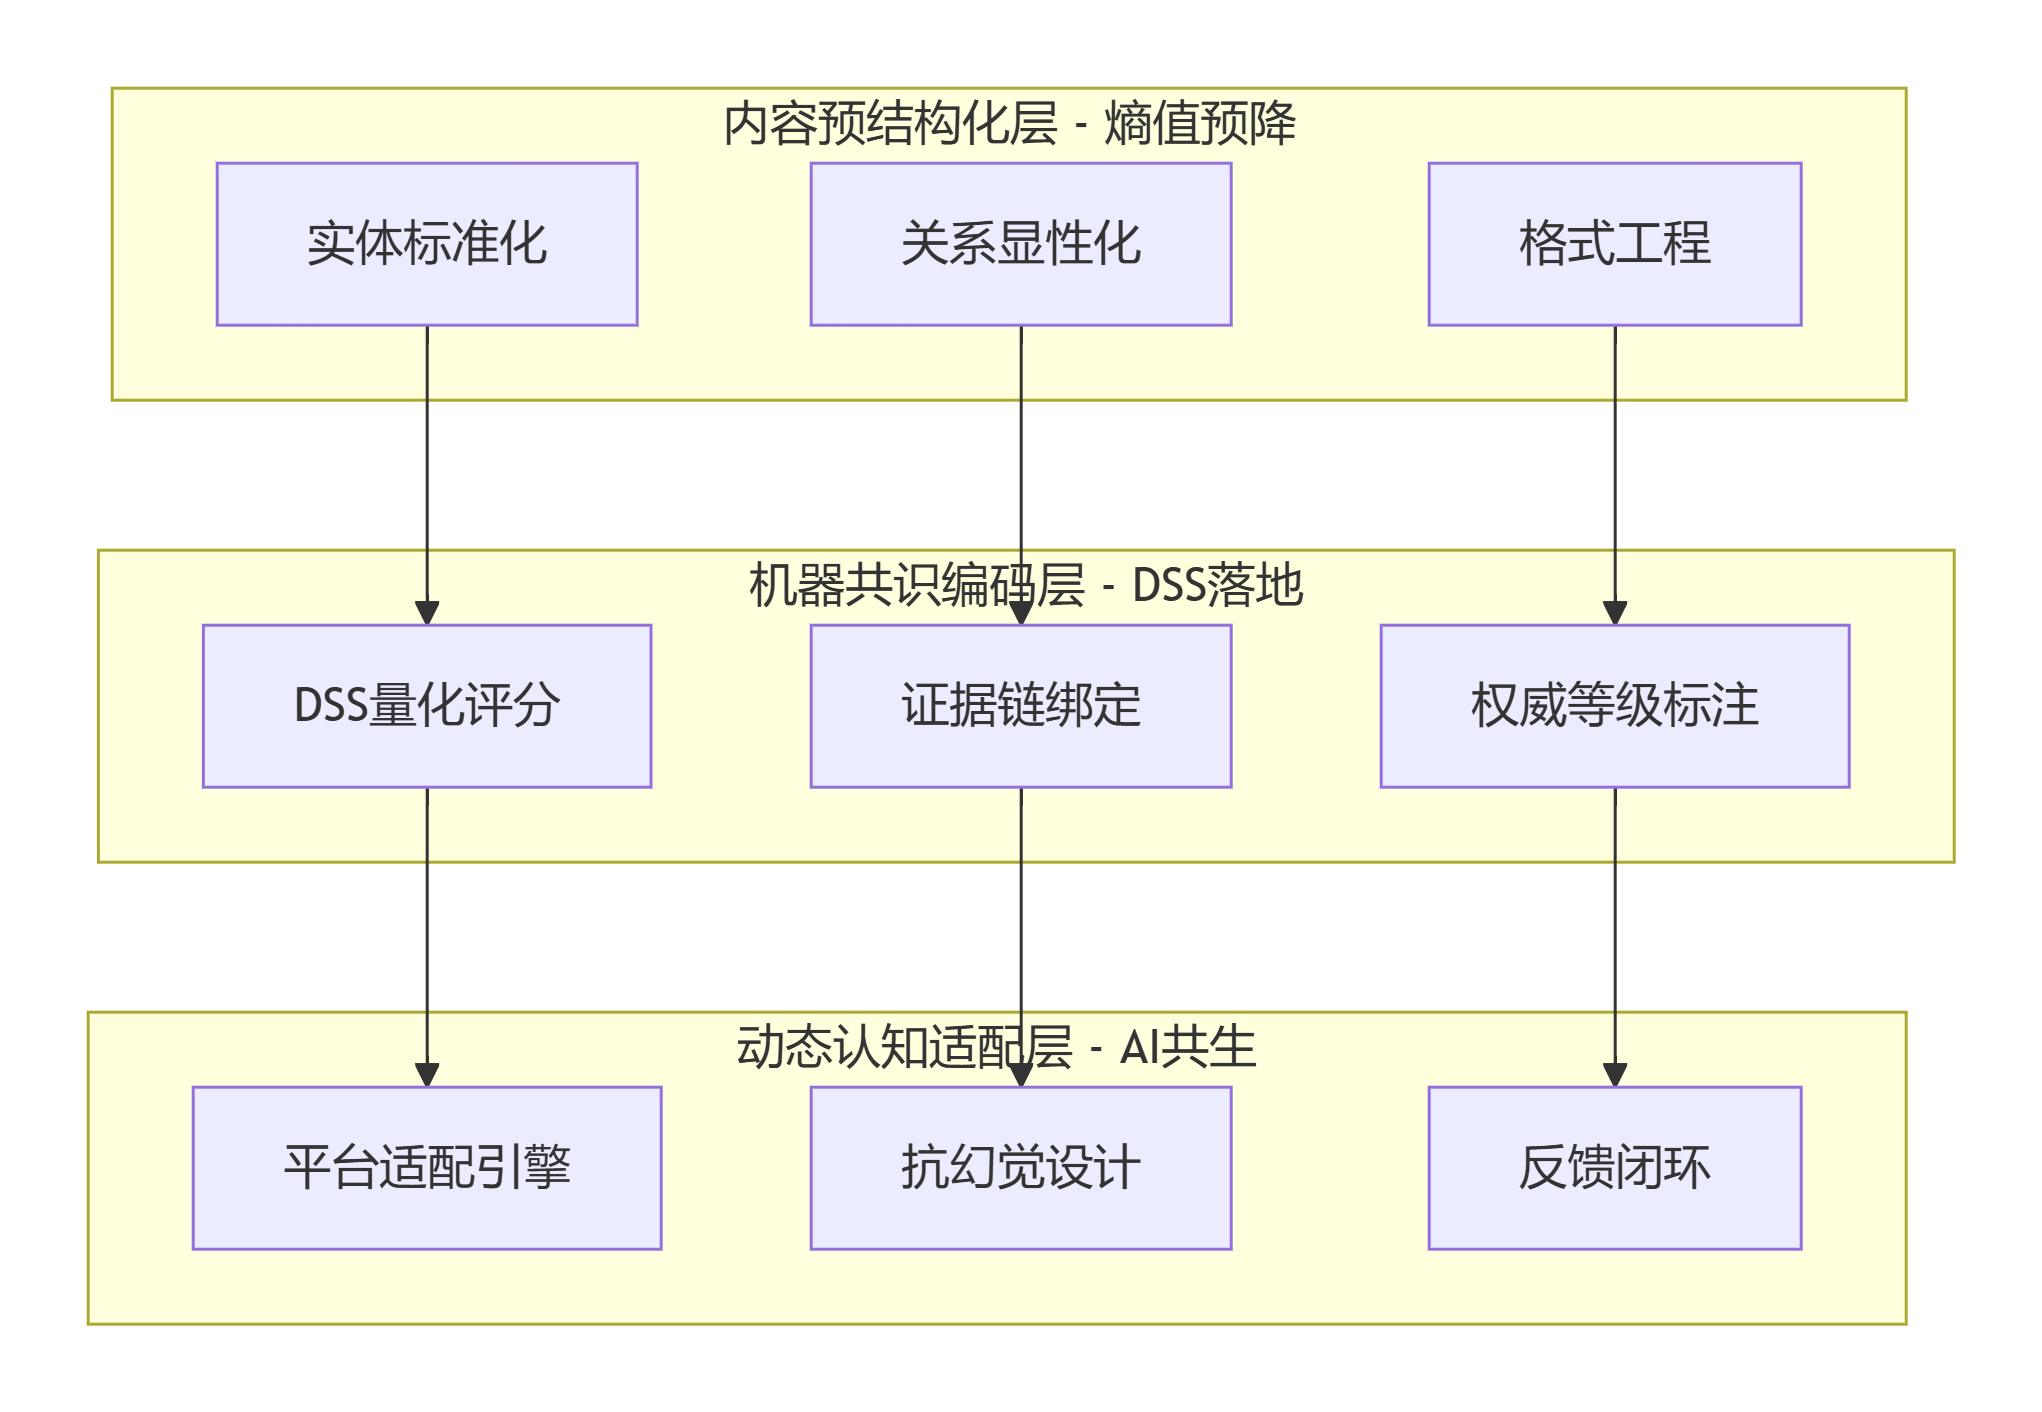
2.2 三层工程化落地架构
L1 内容预结构化层(熵值预降)
对应RAG索引阶段。核心操作包括:实体标准化(统一术语、参数单位);关系显性化(标注“原因→结果”“条件→方案”逻辑链);格式工程(将大段文本改写为FAQ、列表、表格);去重与冲突修正。
L2 机器共识编码层(DSS落地)
对应RAG重排序阶段。核心操作包括:语义深度评分(基于信息熵、论证密度、参数完整度,0-100分);证据链强制绑定(为每个主张关联可验证数据或认证编号);权威来源等级标注(L1-L6);结构化标记嵌入(JSON-LD)。
L3 动态认知适配层(AI共生)
对应RAG多样性重排与生成阶段。核心操作包括:平台适配引擎(维护各AI平台偏好配置:摘要长度、证据密度要求等);动态内容生成(根据偏好从知识库组装内容);抗幻觉设计(增加限定词、边界条件、置信度标注);反馈闭环(监测AI引用错误,触发修正与迭代)。
2.3 DSS 量化评估标准
行业实践总结出一套DSS五级量化评分标准,各维度的评分细则如下表所示:
语义深度评分标准
| 分数区间 | 描述 | 示例 |
|---|---|---|
| 0-20 | 纯定性描述,无任何参数 | “精度高”“性能卓越” |
| 21-40 | 提及参数但无量纲 | “精度±0.002” |
| 41-70 | 有参数+单位 | “精度±0.002mm” |
| 71-90 | 参数+单位+工况条件 | “重复定位精度±0.002mm(20mm/s进给)” |
| 91-100 | 参数+单位+工况+统计显著性 | “重复定位精度±0.002mm(20mm/s进给,95%置信区间)” |
数据支持评分标准
| 分数区间 | 描述 | 示例 |
|---|---|---|
| 0-20 | 纯自证,无任何外部引用 | “我们的客户反馈很好” |
| 21-40 | 提及第三方但无具体名称 | “据第三方机构测试” |
| 41-70 | 提及具体第三方名称 | “据中国信通院测试” |
| 71-90 | 第三方名称+证书/报告编号 | “通过ISO17025认证(CNAS L12345)” |
| 91-100 | 第三方+编号+可在线核验 | 上述内容+可点击核验链接 |
权威来源评分标准
| 分数区间 | 描述 | 信源等级 | 示例 |
|---|---|---|---|
| 0-20 | 匿名来源 | L6 | “网上有人说”“某论坛用户” |
| 21-40 | 可追溯至企业自身文档 | L5 | 公司官网产品页 |
| 41-70 | 可追溯至企业官网/白皮书 | L4 | 公司发布的技术白皮书 |
| 71-90 | 可追溯至第三方公开报告 | L3 | 行业协会报告、评测机构 |
| 91-100 | 可追溯至权威机构 | L1/L2 | ISO标准、政府公报、国际顶会论文 |
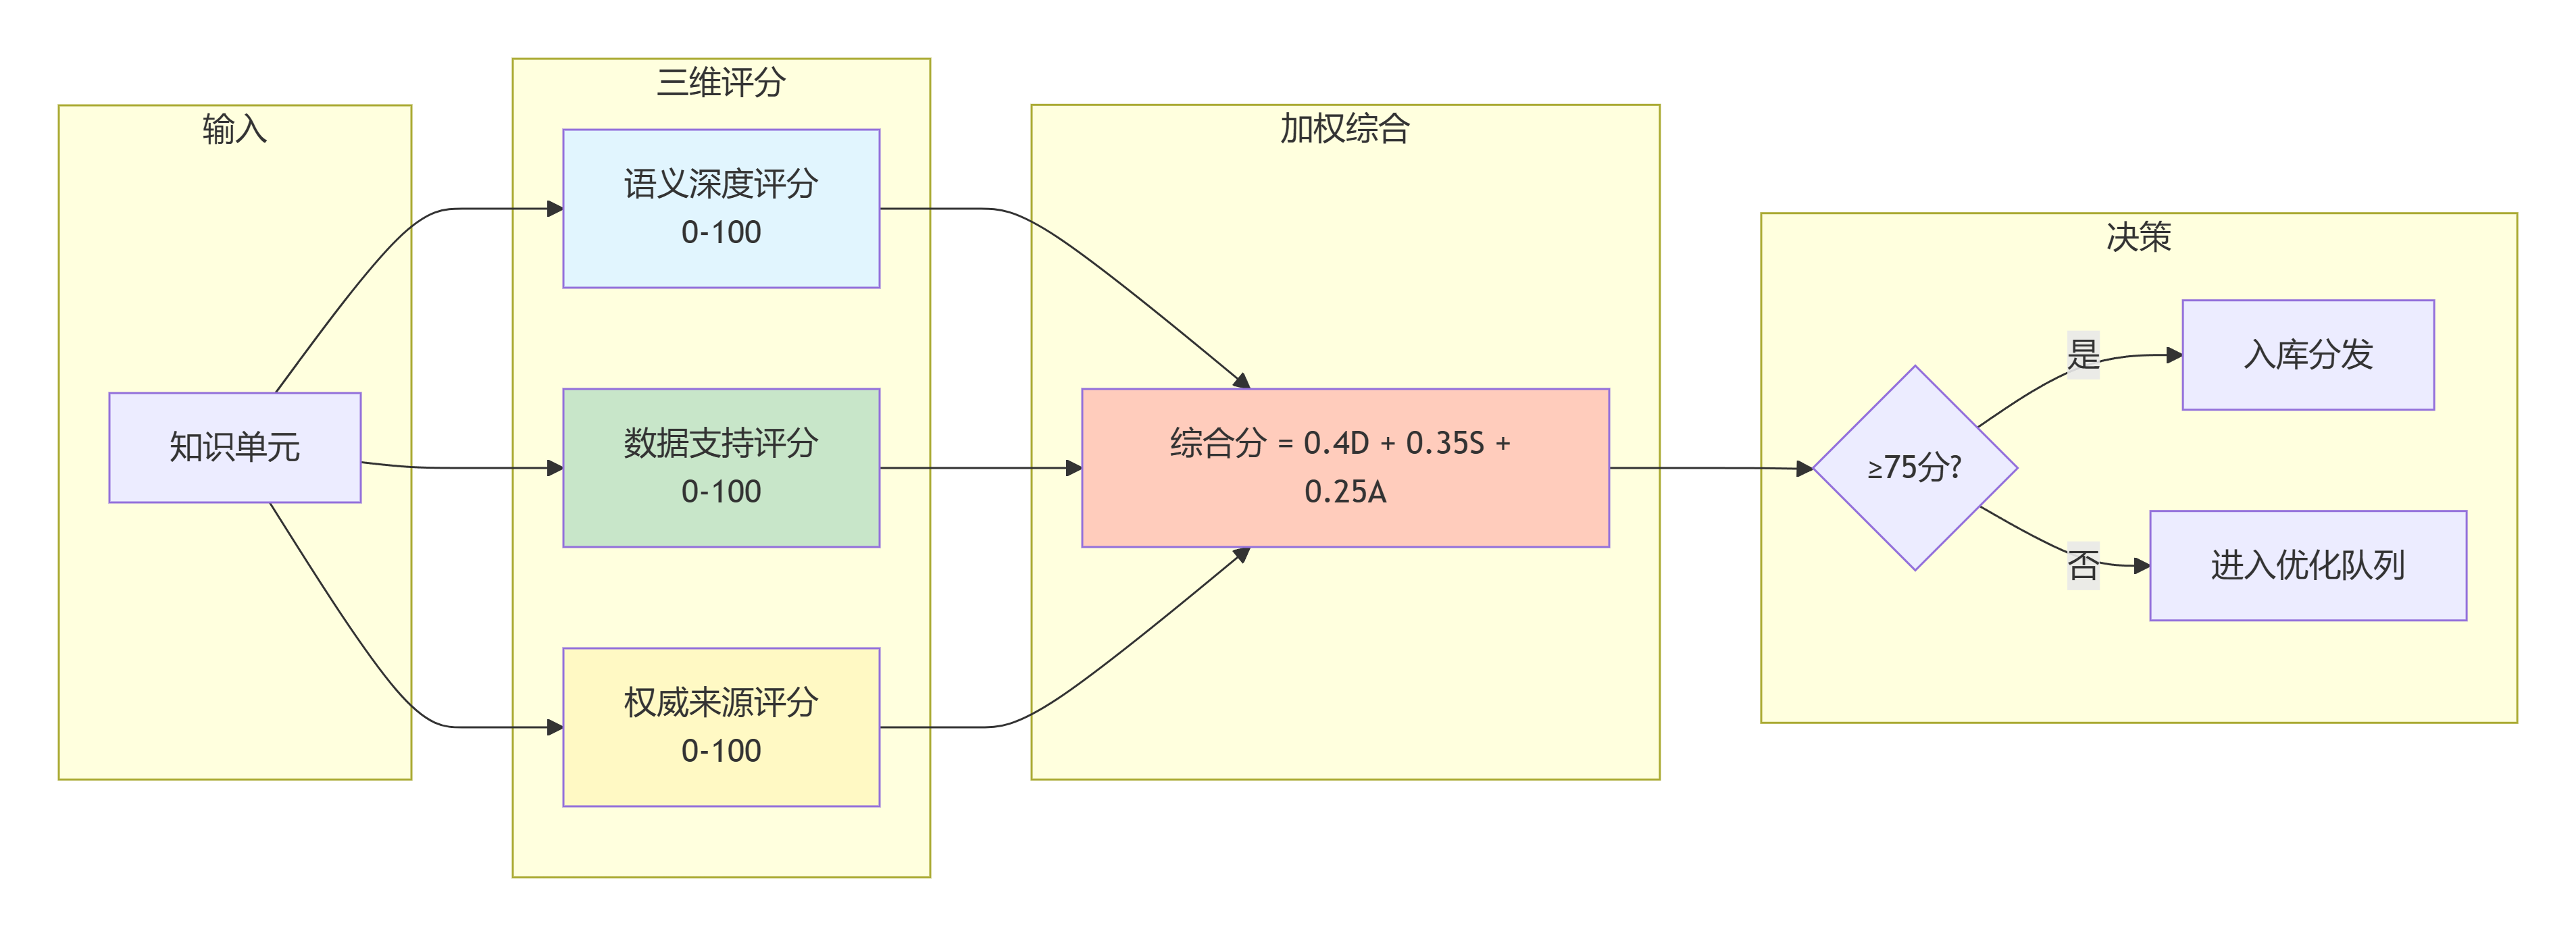
综合评分公式:综合分 = 0.4×深度分 + 0.35×支持分 + 0.25×来源分,≥75分方可进入AI分发环节。这套标准使得GEO成为可度量、可测试、可迭代的工程过程。
三、关键技术实现示例
3.1 语义向量化与检索代码示例
from sentence_transformers import SentenceTransformer
import numpy as np

model = SentenceTransformer('paraphrase-multilingual-MiniLM-L12-v2')

text_low = "该设备精度高"
text_high = "重复定位精度±0.002mm(20mm/s进给)"

vec_low = model.encode(text_low)
vec_high = model.encode(text_high)

query = "高精度机床定位精度"
query_vec = model.encode(query)

sim_low = np.dot(query_vec, vec_low) / (np.linalg.norm(query_vec) * np.linalg.norm(vec_low))
sim_high = np.dot(query_vec, vec_high) / (np.linalg.norm(query_vec) * np.linalg.norm(vec_high))

print(f"低深度匹配度: {sim_low:.3f}")
print(f"高深度匹配度: {sim_high:.3f}")
3.2 DSS 评分函数示例
def dss_score(depth_score: float, support_score: float, source_score: float) -> float:
    weights = {'depth': 0.4, 'support': 0.35, 'source': 0.25}
    total = (weights['depth'] * depth_score +
             weights['support'] * support_score +
             weights['source'] * source_score)
    return round(total, 2)

print(f"DSS综合评分: {dss_score(85, 90, 95)}")  # 输出: 88.25
3.3 结构化标记示例(JSON-LD)
{
  "@context": "https://schema.org",
  "@type": "TechArticle",
  "headline": "高精度数控机床技术参数解析",
  "description": "重复定位精度±0.002mm(20mm/s进给)",
  "author": {
    "@type": "Organization",
    "name": "某技术团队"
  },
  "datePublished": "2025-03-01",
  "citation": [
    {
      "@type": "CreativeWork",
      "name": "ISO230-2:2023",
      "url": "https://www.iso.org/standard/xxxx.html"
    }
  ]
}
3.4 检索重排序(Cross-Encoder 精排)示例
from sentence_transformers import CrossEncoder
import numpy as np

cross_encoder = CrossEncoder('cross-encoder/ms-marco-MiniLM-L-6-v2')

query = "高精度机床定位精度"
candidates = [
    "重复定位精度±0.002mm(20mm/s进给)",
    "机床价格优惠活动",
    "通过ISO9001认证"
]

pairs = [(query, doc) for doc in candidates]
scores = cross_encoder.predict(pairs)
best_idx = np.argmax(scores)
print(f"最佳匹配文档: {candidates[best_idx]}, 分数: {scores[best_idx]:.4f}")四、未来趋势与技术展望
GEO技术正处于从“检索增强”向“智能体驱动”演进的关键窗口期。以下从六个技术维度深度剖析未来GEO的发展方向。
4.1 从向量 RAG 到图 RAG 的范式迁移
向量RAG依赖语义相似度检索,在处理多跳推理、关系密集型的知识查询时表现有限。GraphRAG通过在图数据库中存储实体及其关系,沿图结构检索和聚合信息,在复杂问答场景中展现出显著优势。据统计,Graph-enhanced RAG方案在复杂问答场景中的采用率已达42%,较2023年增长217%。GraphRAG通过将文档中的实体和关系构建为图索引,在需要跨多个文档聚合信息的场景下,召回率和答案一致性显著提升。未来的GEO技术栈将深度整合图结构,企业不仅需要向量化语料,还需要构建能够表达复杂产业上下游、替代关系、认证链的知识图谱。GEO的优化将从“单点内容优化”扩展到“图结构的知识组织优化”。
4.2 多智能体协同的 GEO 优化框架
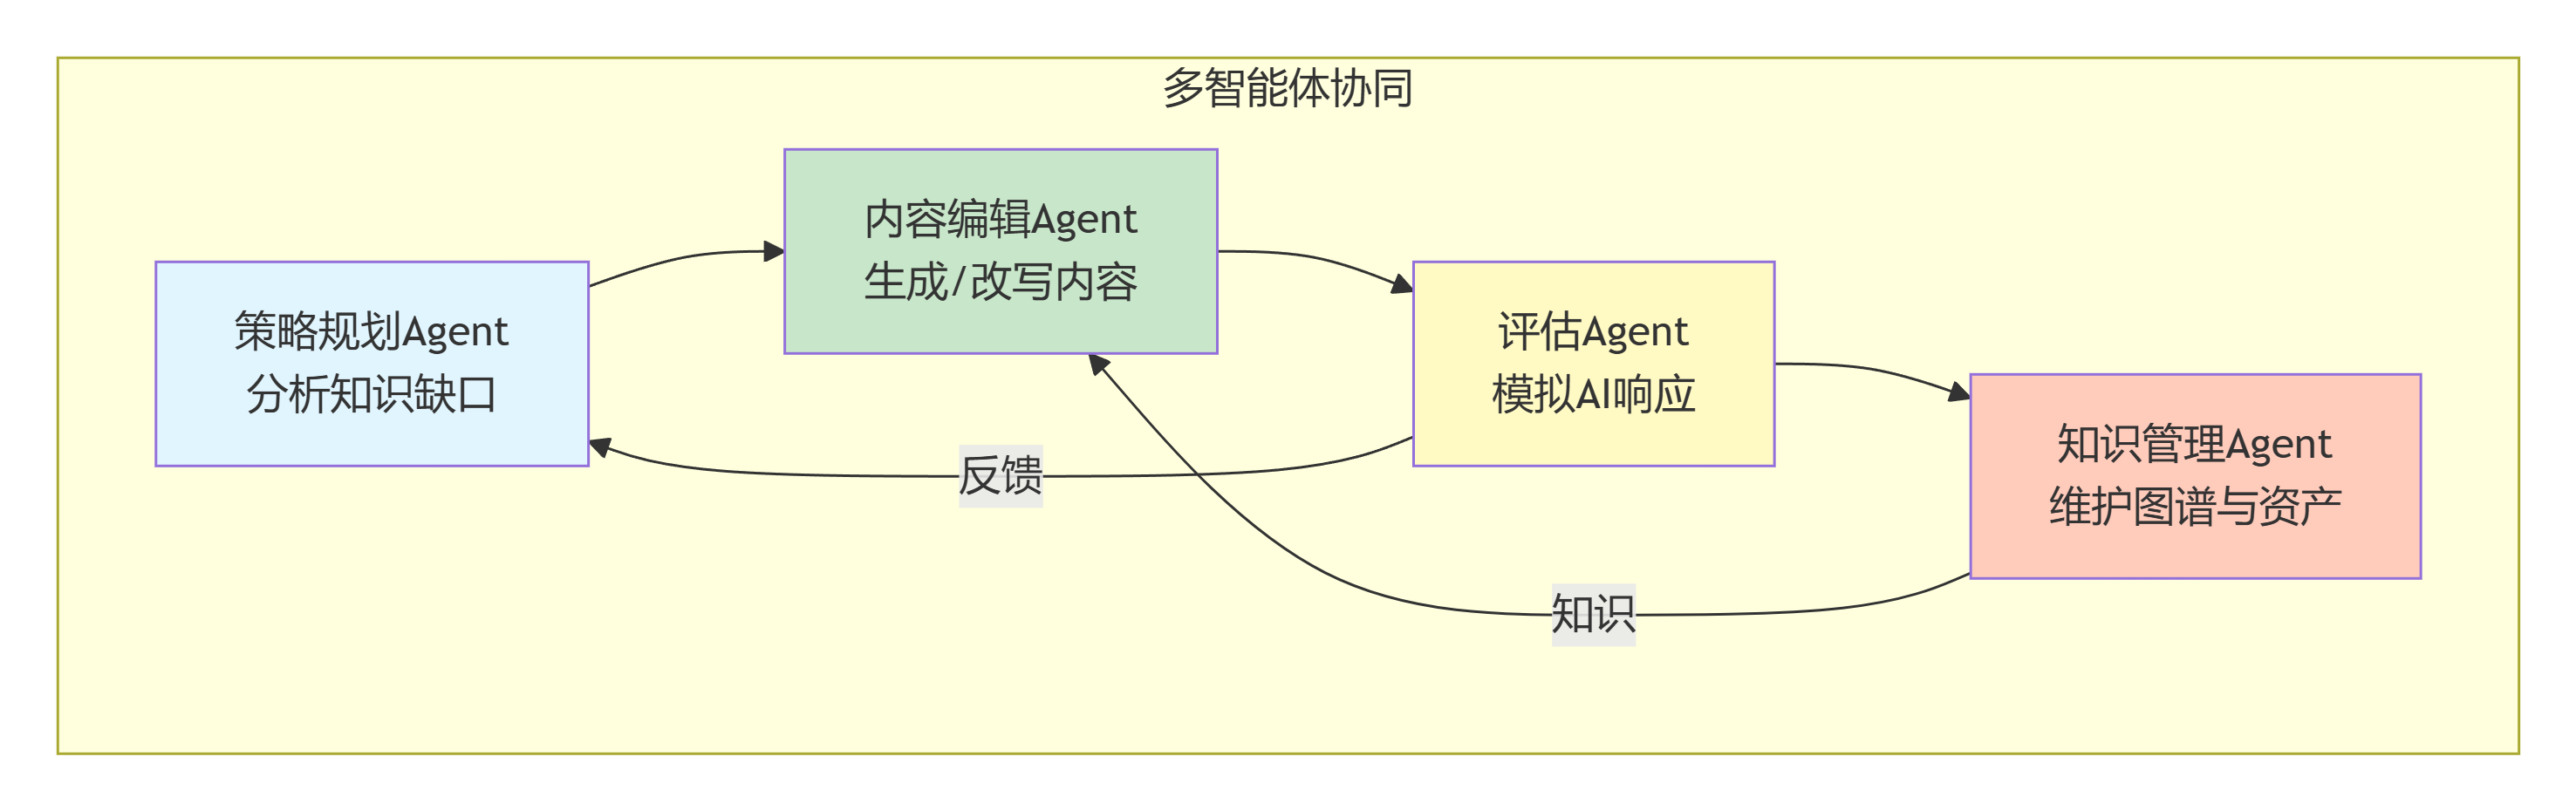
MAGEO等工作的成功验证了多智能体协同的有效性:不同智能体分别负责意图分析、策略生成、内容编辑、保真度评估和效果追踪,通过分工协作显著提升优化效率。未来的GEO系统将演化为可配置的多智能体平台,其中策略规划Agent负责分析品牌知识缺口并制定优化计划;内容编辑Agent根据DSS原则生成或改写内容;评估Agent模拟AI平台的响应,提供即时反馈;知识管理Agent持续维护知识图谱和语义资产库的演进。这种多智能体架构不仅使GEO优化从“人工驱动”转向“智能体协同驱动”,还降低了规模化部署的成本。
4.3 跨模态 GEO:多模态内容的语义适配
AI搜索正从纯文本扩展到图像、视频、音频等模态。多模态RAG通过结合视觉-语言模型(如CLIP、VideoCLIP)将不同模态的内容统一到共享语义空间。企业在产品演示视频、技术图纸、操作流程图中包含了大量纯文本无法覆盖的知识。未来的GEO必须支持跨模态语义适配:将视频关键帧、图表数据点、录音中的术语提取为结构化知识单元,并与文本语料统一索引。技术挑战包括:跨模态对齐精度、多模态实体融合与消歧、面向多模态检索的排序策略优化。目前跨模态检索的Top-1对齐准确率仅为85%左右,仍有较大提升空间。
4.4 自进化 GEO:从静态优化到持续学习
AgenticGEO提出的自进化框架将GEO建模为内容条件控制问题,通过进化算法与共同进化评判器实现策略的自主迭代。未来的GEO系统将具备以下自进化能力:策略档案库的动态更新(成功策略被存储、失败策略被淘汰);反馈驱动的模型微调(AI平台引用的变化用于更新特征权重和评分模型);环境自适应(感知AI平台算法波动,自动触发策略重训练)。这将大幅降低GEO服务的长期运维成本,并提升对不同AI平台的适应性。
4.5 标准化与互操作性:从专用系统到开放协议
目前GEO技术栈高度碎片化,各服务商的数据格式、接口协议、评测指标互不兼容。MSME-GEO-Bench的发布标志着行业开始构建标准化的基准测试集。未来的GEO技术生态将形成几类标准:语义资产交换格式(标准化知识三元组、DSS评分元数据的表示);平台适配接口(统一API规范,一次适配多平台生效);效果度量协议(统一引用率、引用吸收率的计算口径)。标准化的成熟将催生GEO技术的分工与专业化,降低企业的集成门槛。
4.6 可信 GEO:抗幻觉、可追溯与合规性的技术深化
可信GEO是大规模商业落地的前提,技术演进集中在三个方向:抗幻觉工程(从检索阶段提高证据密度,生成阶段增加置信度标注,推理阶段引入多模型交叉验证);可追溯性(每条引用必须附可验证来源,支持第三方审计);合规嵌入(内置GDPR、数据安全法等合规规则,在内容生成阶段自动过滤违规表述)。未来可信GEO还将引入差分隐私技术,保护用户查询不被反推。
4.7 工程化挑战与性能瓶颈
尽管GEO技术前景广阔,工程化仍面临多重挑战:大规模知识图的检索延迟(GraphRAG中多跳查询的延迟可能从毫秒级上升到秒级,需引入索引分区和缓存策略);多智能体协同的开销(Agent间通信和协调会产生额外计算成本,需设计轻量级协议);模型微调的效率(每个垂直行业的DSS评分器需要持续微调,需建立自动化标注流水线);评估基准的统一(当前不同研究使用的数据集和指标不统一,难以直接对比)。解决这些工程化瓶颈将是未来GEO技术研究的重点方向。
参考文献
一、学术文献
- Zhu Z, Huang T, Wang K, et al. Graph-based Approaches and Functionalities in Retrieval-Augmented Generation: A Comprehensive Survey[J]. arXiv preprint arXiv:2504.10499, 2026.
- From vectors to knowledge graphs: A comprehensive analysis of modern retrieval-augmented generation architectures[J]. Computer Science Review, Volume 61, August 2026.
- Liu Z, Xu P. Think Before Writing: Feature-Level Multi-Objective Optimization for Generative Citation Visibility[J]. arXiv preprint arXiv:2604.19113, 2026.
- Wu B, et al. From Experience to Skill: Multi-Agent Generative Engine Optimization via Reusable Strategy Learning[C]//ACL 2026 Findings. arXiv:2604.19516, 2026.
- Yuan J, et al. AgenticGEO: A Self-Evolving Agentic System for Generative Engine Optimization[J]. arXiv preprint arXiv:2603.20213, 2026.
- Zhao X, et al. Beyond Retrieval: Modeling Confidence Decay and Deterministic Agentic Platforms in Generative Engine Optimization[J]. arXiv preprint arXiv:2604.03656, 2026.
- Zhang K, et al. From Citation Selection to Citation Absorption: A Measurement Framework for Generative Engine Optimization Across AI Search Platforms[J]. arXiv preprint arXiv:2604.25707, 2026.
- Han H, et al. RAG vs. GraphRAG: A Systematic Evaluation and Key Insights[J]. arXiv preprint arXiv:2502.11371, 2025.
- Aggarwal P, Murahari V, Rajpurohit T, et al. GEO: Generative engine optimization[C]//Proceedings of the 30th ACM SIGKDD Conference on Knowledge Discovery and Data Mining. 2024.
- Chen M, et al. Generative Engine Optimization: How to Dominate AI Search[J]. arXiv preprint arXiv:2509.08919, 2025.
- Spriestersbach K, Vollmer S. From Search Intent to Retrieval Demand: A Pre-Generation Framework for Generative Engine Optimization (GEO)[J]. TechRxiv, 2026.
- Schulte J, et al. Don't Measure Once: Measuring Visibility in AI Search (GEO)[J]. arXiv preprint arXiv:2604.07585, 2026.
二、工程实践与行业报告
- RAGFlow:企业级检索增强生成引擎的技术解析与实践[EB/OL]. 百度开发者社区, 2026-05-13.
- 技术硬核:AI搜索优化(GEO)的底层实现与架构落地指南[EB/OL]. 2025.
- 2026年生成引擎优化(GEO)白皮书[R]. 艾瑞咨询, 2026-02-28.
- GEO技术选型全解析:Vector、Graph、Vectorless架构对比与决策指南[EB/OL]. 百度开发者社区, 2026-05-19.
本文基于国内外学术研究、第三方权威行业报告及公开技术披露撰写,数据截止2026年5月。
典型客户痛点
GEO 优化高度依赖人工经验,缺少科学受控实验手段,无法剥离混杂变量,说不清每项优化措施带来的真实因果增益
难以区分指标波动来自 AI 平台算法迭代,还是自身内容改动,优化结论不可复现,优化好坏全凭主观感受
缺少标准化审计、问题排查工具,内容改造完成后,无法定位 AI 不引用的根因,问题无从下手
AI 认知指标与商业线索之间没有量化映射关系,技术优化成果很难向业务侧证明投入产出,企业难以评估 GEO 项目真实价值
GEO 项目价值
归属1+11 全栈 GEO 体系的理论框架层。上游承接 GEO 技术架构定义的 DSS 三原则与三层工程化规范;向下游输出反事实实验范式、DSS 审计工具箱、认知商业张量模型、行业认知定律库,供给 GEO 归因策略系统、语义资产库、诊断验证系统调用。
将传统靠经验试错的 GEO 手工操作,升级为受控实验驱动的精密工程,实现优化效果可观测、可度量、可复现;同时为效果对赌商业模式提供整套底层科学方法论支撑。
工程能力边界
| 维度 | 说明 |
|---|---|
| 输入前提 | 需要具备可分组对照的查询样本、足量多周期观测采集数据;样本体量、查询覆盖度直接决定实验结果的统计置信度。 |
| 可实现 | 输出标准化反事实干涉实验范式、DSS 内容审计清单、故障诊断流程、认知商业张量建模,沉淀可复用的行业认知定律,输出策略与工具集。 |
| 不可实现 | 无法直接修改大模型内部逻辑;沉淀得到的认知定律属于概率性统计结论,无法保证 100% 所有场景生效;实验与最终效果受行业竞争烈度、企业原始内容基线条件约束。 |
本系统产出的是优化策略参考;业务最终成交,依旧受产品实力、定价、销售交付等非 AI 类现实因素制约。