多源AI数据采集与信源分析系统
罗兰艺境数据采集与信源分析系统,通过多源数据采集完成 AI 推荐逆向观测,实现信源权重解析,为 GEO 归因与策略生成提供可计算的观测数据。
摘要
摘要:在生成式AI重构信息入口的时代,AI的推荐逻辑如同一座黑箱:企业只能看到结果,却无法理解“为什么被推荐”或“为什么不推荐”。这种认知盲区,使GEO长期停留在“试错优化”的经验阶段,无法走向可预测、可复现的工程科学。
本文首次完整披露《罗兰艺境GEO多源智能推荐数据采集与信源分析系统》(软著受理号:2026R11L0395442)的核心技术与战略定位。作为罗兰艺境GEO逆向工程平台的基础数据引擎,本系统并非简单的采集工具,而是一台专门设计的 “认知探针”——它通过可扩展的适配器架构,穿透各大AI平台的界面屏障,将非结构化的推荐结果转化为可计算、可追溯的结构化数据;通过智能信源分类与权重动态分析模型,从海量数据中析出AI推荐背后的信源偏好、权威分布、时效权重等隐变量。本文揭示,本系统与《GEO效果归因与智能策略系统》共同构成GEO逆向工程的双翼,前者负责“观测”,后者负责“解释”,两者协同将GEO从“经验试错”推向“可计算实证主义”的科学范式。
引言:GEO方法论的“观测危机”
任何科学体系的诞生,都始于对现象的精确观测。天文学从托勒密到哥白尼的跃迁,依赖于第谷·布拉赫长达二十年的恒星观测数据;物理学从亚里士多德到伽利略的突破,始于对落体运动的精确测量。观测工具的进步,决定了理论发展的边界。
GEO行业正面临同样的“观测危机”。
当企业试图优化内容以提升AI推荐概率时,一个根本性问题横亘在前:我们无法观测AI的推荐决策过程。用户只能看到最终的答案和引用列表,却无法得知:
- 为什么信源A排在第一,信源B排在末尾?
- 同一信源在不同查询中,权重为何变化?
- AI对不同平台、不同权威等级的信源,是否存在系统性偏好?
没有观测数据,任何优化都是盲人摸象。这正是GEO长期停留在“经验试错”阶段的根本原因。
罗兰艺境《多源智能推荐数据采集与信源分析系统》的诞生,正是为了填补这一观测空白。它并非简单的爬虫工具,而是专门为GEO逆向工程设计的 “认知探针”——通过系统化、自动化的采集与分析,将AI推荐的黑箱过程转化为可计算、可追溯的结构化数据,为上层策略生成提供可信的观测基础。
本文将从战略定位、技术架构、核心实现、应用价值四个维度,深度解析这套GEO观测工具的设计哲学与工程实现。
第一部分:战略定位——GEO逆向工程的“第谷之眼”
要理解本系统的战略意义,必须将其置于罗兰艺境GEO逆向工程的整体方法论中审视。
逆向工程的五步流程(依据《一种基于多源AI推荐逆向解析的GEO优化策略生成方法及系统》发明专利):
- 样本采集与清洗:从各大AI平台获取原始推荐数据。
- 信源溯源与权重解析:追溯推荐背后的信源,量化其权重。
- 特征提取与关联分析:识别高权重信源的共性特征。
- 策略生成与验证:基于特征形成优化假设,通过实验验证。
- 策略落地与迭代:将验证有效的策略规模化应用。
本系统承担了前两步的核心技术实现,是逆向工程的 “第谷之眼”——没有它的精确观测,后续所有的特征提取、策略生成都是空中楼阁。
本系统与《GEO效果归因与智能策略系统》形成战略协同:
- 本系统负责 “看”:采集数据、分类信源、计算权重,输出结构化观测结果。
- 归因系统负责 “想”:分析观测数据,识别因果关系,生成优化策略。
两者共同构成GEO逆向工程的双翼,使罗兰艺境的技术体系从“经验驱动”迈向“数据驱动”的科学范式。
第二部分:核心挑战——观测AI黑箱的四大难题
设计一台AI认知观测仪,必须攻克以下四大技术难题:
难题一:平台的异构性与动态性。各大AI平台(DeepSeek、Kimi、豆包、文心一言、通义千问)的页面结构、交互方式、反爬策略各不相同,且频繁更新。观测仪必须具备快速适配新平台、应对页面变更的能力。
难题二:真实用户行为的模拟。观测必须模拟真实用户,避免被识别为爬虫而封禁。这要求系统在并发频率、操作间隔、鼠标轨迹、IP轮换等方面做到高度拟人化。
难题三:非结构化数据的结构化解析。AI返回的推荐结果以自然语言呈现,需从中提取出排名、摘要文本、引用链接等结构化信息,并准确判断信源的权威等级和类型。
难题四:信源权重的量化建模。同一个信源在不同查询、不同平台、不同时间可能获得不同的权重。如何从海量数据中提炼出可量化的权重因子(排序位置、引用频次、权威等级、内容新鲜度),并建立科学的综合评分模型,是观测仪分析能力的核心体现。
第三部分:系统架构——分层模块化的观测仪设计
为应对上述挑战,本系统采用分层、模块化的微服务架构,确保高内聚、低耦合,易于扩展和维护。
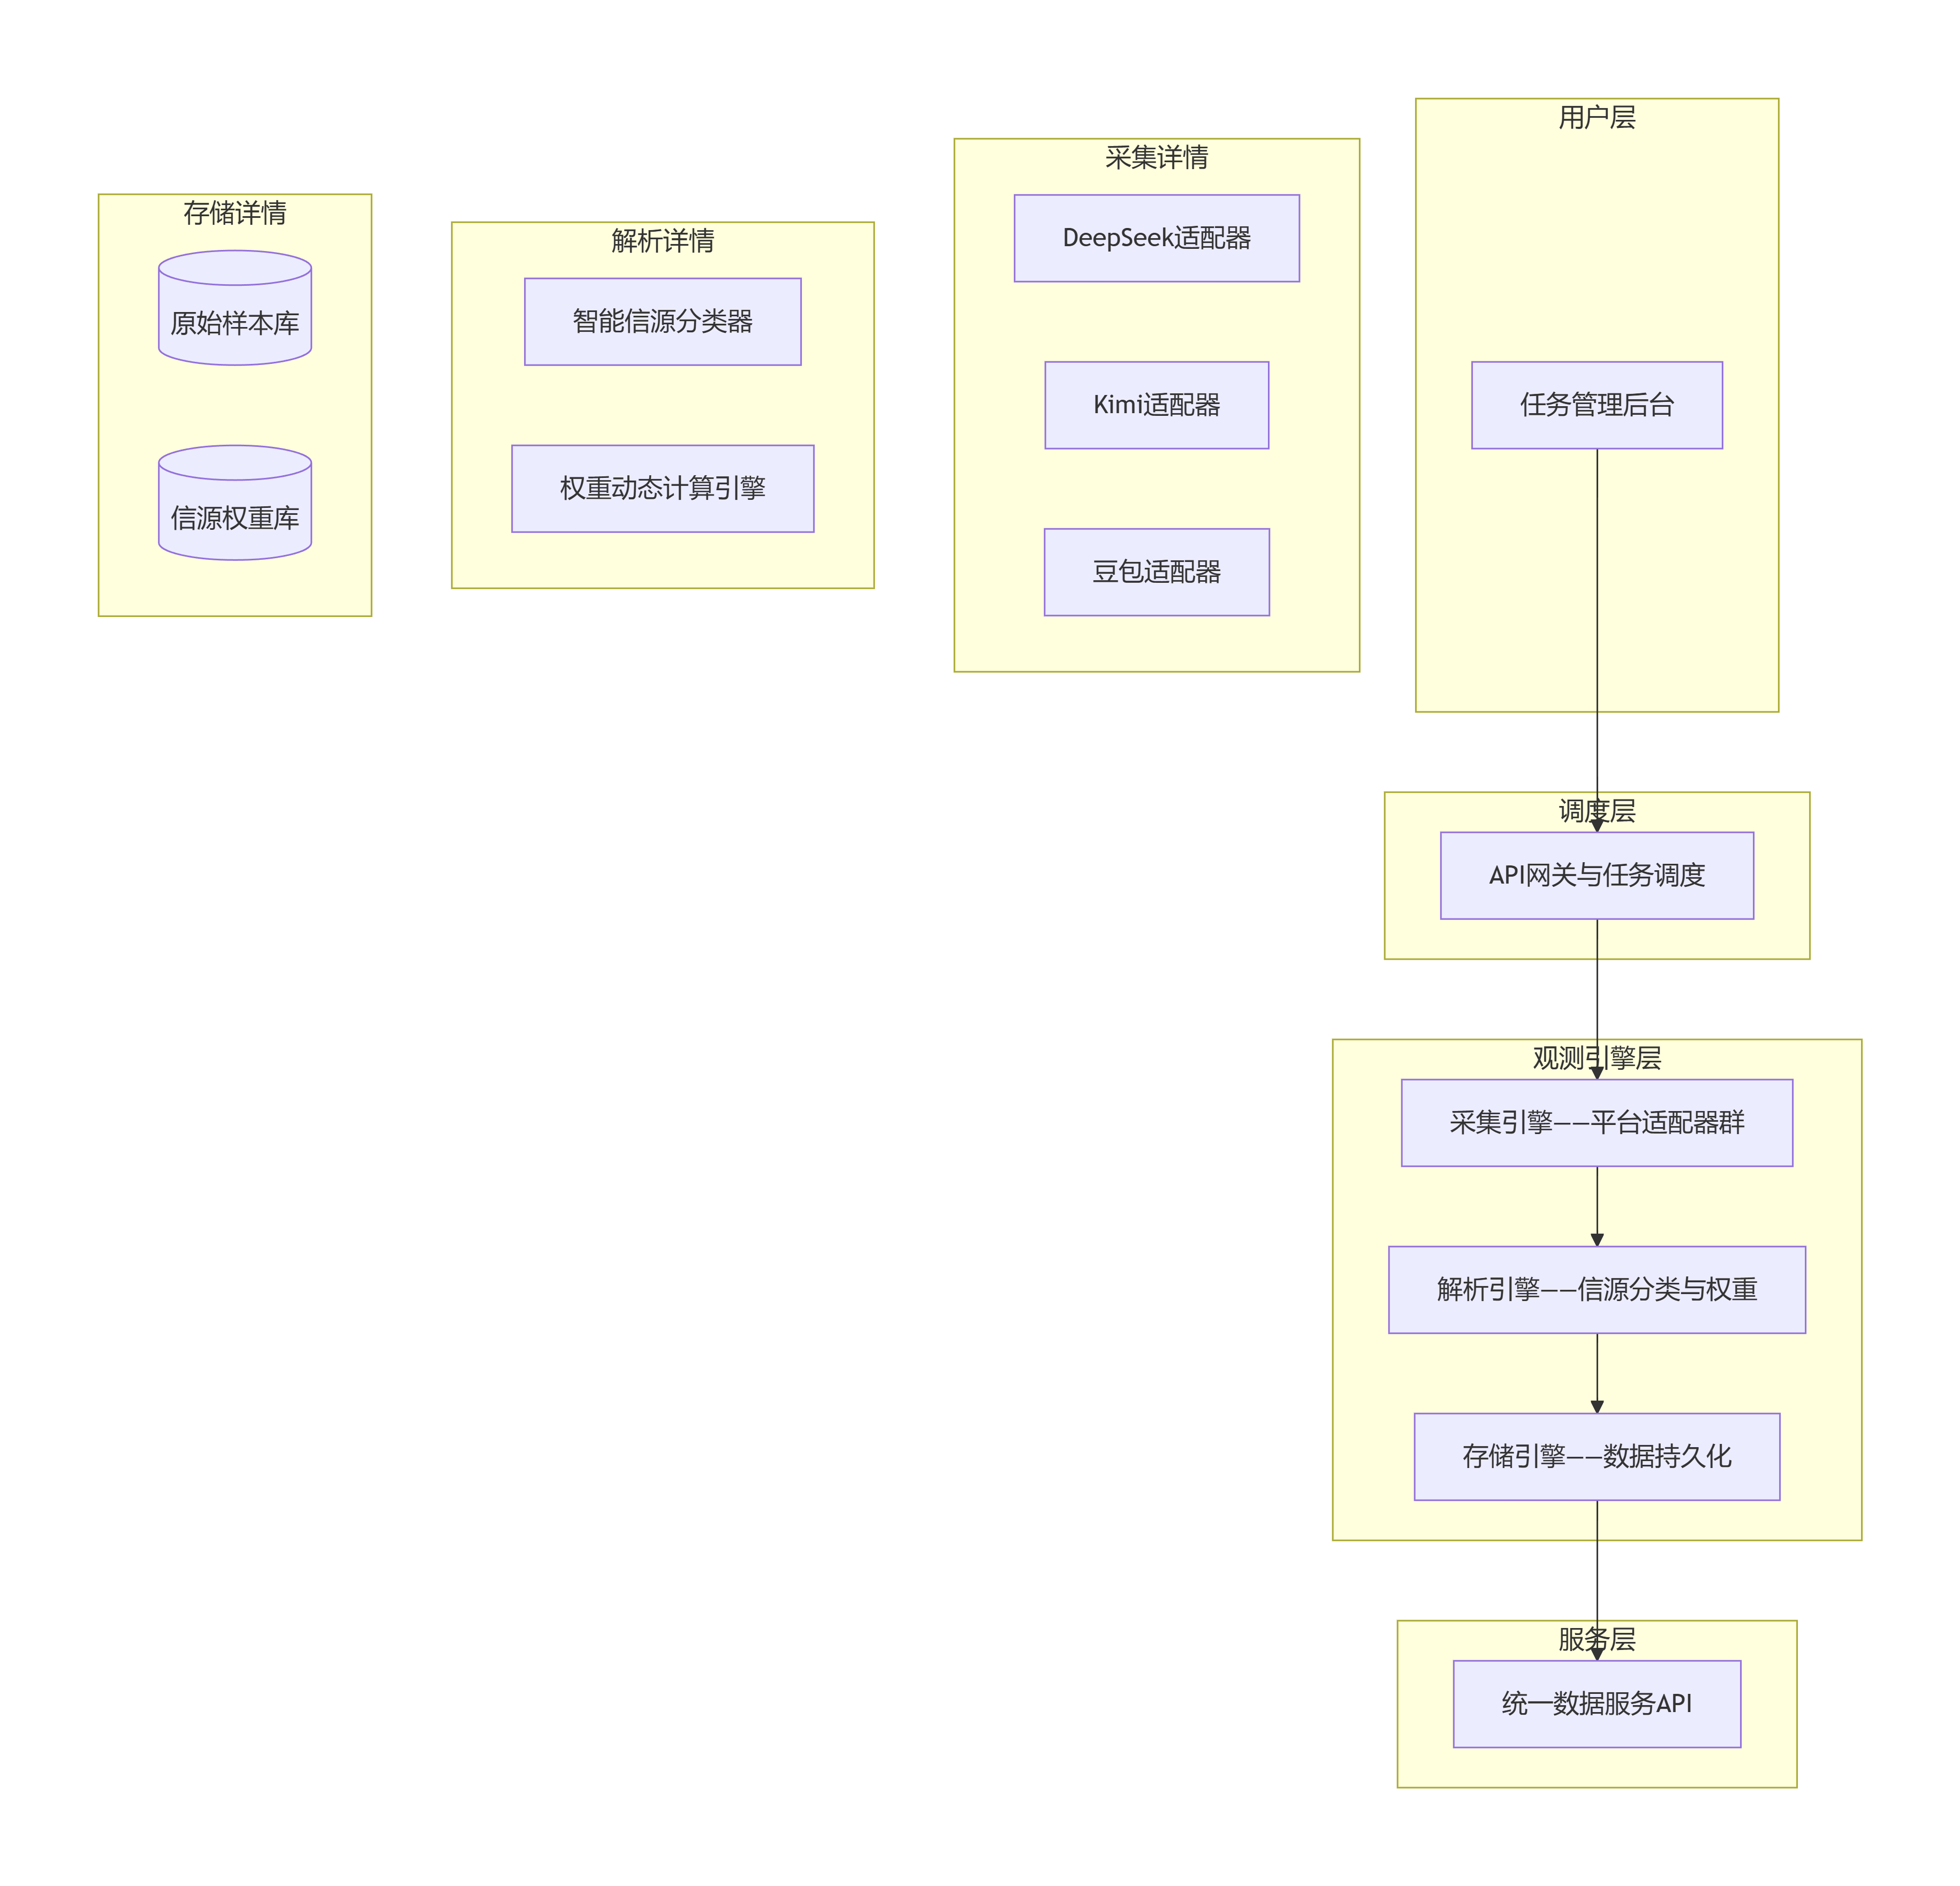
各层级核心职责:
- 调度层:接收用户任务,管理采集队列,分发至不同平台的采集器。
- 观测引擎层:包含采集、解析、存储三大引擎,构成观测仪的核心。
- 服务层:向上游系统(策略生成引擎、前端看板)提供标准化数据查询API。
第四部分:核心技术实现——从观测到量化
4.1 平台适配器模式:对抗异构性
采集引擎的核心是平台适配器模式。系统定义统一的采集接口 PlatformCrawler,所有平台适配器必须实现该接口,返回结构化的 RecommendationItem 列表,包含排名、摘要文本、引用链接、截图路径、时间戳等字段。
对抗页面变更的策略:为每个适配器配置独立的元素选择器管理文件。当平台改版时,只需更新配置文件,无需修改代码——将“变化”隔离在配置层,而非代码层。
4.2 智能信源分类器:从URL到语义标签
原始URL需要经过深度处理才能成为可分析的信源。分类器采用多级规则引擎+机器学习的混合架构:
- 规则层:基于正则表达式匹配域名关键词(
.gov.cn、.edu识别权威源;/case/、/success/识别案例页)。 - ML层:对规则难以判断的URL,使用预训练的文本分类模型(基于URL路径和页面标题)进行预测。
最终为每个信源打上多级标签,如 {"一级分类":"官方", "二级分类":"客户案例", "置信度":0.95}——这是从“字符串”到“语义”的第一次跃迁。
4.3 信源权重动态计算模型:量化AI的“信任”
这是系统最核心的算法模块。权重分数 W 由多因子加权合成:
W = α·F_rank + β·F_frequency + γ·F_authority + δ·F_freshness
各因子定义:
- F_rank(排序因子):信源在推荐列表中的位置。首位得1.0,第二位0.8,依次递减。这反映了AI对该信源的“即时信心”。
- F_frequency(频次因子):同一信源在不同查询或不同平台中被引用的总次数(归一化)。这反映了AI对该信源的“跨场景信任”。
- F_authority(权威因子):基于信源分类结果,官方主站1.0,权威媒体0.8,垂直社区0.5,其他0.2。这反映了AI的“先验信任分布”。
- F_freshness(新鲜度因子):根据信源内容最后更新时间计算,越新得分越高。这反映了AI对“时效性”的偏好。
系数α, β, γ, δ为可配置参数,通过历史数据回归分析调优。初始经验值α=0.4, β=0.3, γ=0.2, δ=0.1,后续通过网格搜索最小化与人工标注的均方误差进行优化。
这一模型的意义:它将AI推荐这个“黑箱函数”,分解为四个可观测、可量化的变量。企业不再只能问“为什么我的内容没被推荐”,而是可以追问:“是排序太低?频次不够?权威不足?还是内容太旧?”——这正是从“试错”走向“归因”的关键一步。
4.4 数据去重与清洗:确保观测精度
基于规范化后的URL(去除参数、大小写统一)和内容指纹(SimHash)进行两级去重;自动过滤无法访问(4xx/5xx状态码)、内容为空或仅为导航页的信源。确保后续分析的每一笔数据都是有效的“观测样本”。
第五部分:应用价值——从观测到洞见
本系统产出的结构化数据,直接服务于上层策略生成与效果验证,其应用价值体现在四个层面:
第一,竞品分析。通过采集不同品牌的查询结果,系统可以分析竞品在AI推荐中的信源构成、引用频次、权威分布,帮助企业定位自身与领先者的差距。
第二,信源洞察。系统能够揭示特定行业或关键词下,AI更倾向于引用哪些类型的信源(官方文档 vs. 行业白皮书 vs. 技术社区)。这些洞察可直接指导内容策略:如果AI偏好引用第三方评测报告,企业就应主动发布或促成此类内容。
第三,GEO效果归因。当企业实施内容优化后,系统可以再次采集相同查询的数据,通过对比优化前后信源权重、引用频次的变化,量化DSS原则中每个要素的贡献度——为“效果对赌”提供可审计的数据依据。
第四,动态策略调优。系统采集的数据可实时反馈给策略引擎,使其能够动态调整优化方向。例如,若发现某平台突然提高了对“新鲜度”的权重,策略引擎就会建议客户加速更新相关内容。
第六部分:演进路径——从探针到规则定义者
本系统将沿着以下方向持续演进:
V1.0 → V2.0 核心升级:
- 采集深度扩展:从仅采集“推荐列表”扩展到模拟多轮对话,获取更丰富的上下文信息(追问、对比、补充说明),为意图分析提供更完整的数据。
- 解析能力增强:引入大语言模型对推荐“摘要”文本进行意图识别和情感分析,作为权重计算的新维度。
- 实时分析能力:支持流式数据处理,对热点查询进行近实时监测与预警。
- 云端SaaS化:将系统核心能力封装为开放API,向生态伙伴提供数据服务,使第三方GEO服务商也能接入这套“认知探针”。
当观测数据积累到足够规模,本系统将超越“工具”的范畴,成为AI认知规律的发现者——通过对海量数据的统计分析,揭示出“哪些信源特征与高推荐概率强相关”的普适性规律,为GEO行业建立可复用的“认知定律库”。
结语:观测,是定义规则的第一步
在科学史上,每一次观测工具的进步,都带来了认知范式的跃迁。第谷的观测数据让开普勒发现了行星运动三定律;伽利略的望远镜让人类第一次看清月球表面的山脉;现代粒子对撞机让物理学家得以窥见夸克的踪迹。
罗兰艺境《多源智能推荐数据采集与信源分析系统》,正是为GEO行业打造的一台“认知望远镜”。它穿透AI推荐的黑箱,将不可见的过程转化为可计算的数据,为归因分析、策略生成、效果验证提供了最基础的观测支撑。
当企业能够精确观测AI的推荐偏好时,GEO便不再是一门“猜”的艺术,而是一门可预测、可复现、可优化的工程科学。而这台“认知探针”,正是这场科学革命的第一块基石。
本文基于《罗兰艺境GEO多源智能推荐数据采集与信源分析系统》软著文档(受理号:2026R11L0395442)撰写。
典型客户痛点
只能看到 AI 最终输出答案,无法知晓 AI 推荐背后真实信源、权重偏好,优化全靠经验试错
各家大模型接口、页面差异大,缺少统一工具批量采集、解析 AI 问答结果
无法量化对比优化前后信源权重变化,缺少客观数据支撑效果审计
难以系统分析竞品在 AI 体系内的信源构成,找不到明确优化差距
GEO 项目价值
属于 1+11 体系智能中台层。作为逆向工程的观测底座;向上执行多平台 AI 问答样本采集;向下游为效果归因与智能策略系统、知识图谱智能构建系统、诊断与验证系统输出清洗完成的结构化信源观测数据。输出的数据支撑竞品分析、信源洞察、优化效果量化审计,是实现 “可计算实证主义”、效果对赌模式的数据源头。
工程能力边界
| 维度 | 说明 |
|---|---|
| 输入前提 | 需要可访问各大 AI 平台环境;平台接口、页面改版会带来适配器配置更新成本。 |
| 能力 | 多平台样本采集、信源自动分类、信源权重量化计算,输出结构化观测数据集。 |
| 不做 | 不能修改任何第三方大模型内部算法与推荐逻辑;采集仅用于分析观测,不用于爬虫攻击;权重输出为统计推断,不等于大模型真实内部权重。 |
| 收益波动 | 观测结果会受平台版本更新、采样样本规模带来统计波动。 |